摘要:国内大量制造企业攒下了数年的工业生产数据,却因为数据乱、杂、脏没法用,砸钱做的大数据平台大多沦为摆设。笔者参与过3个离散制造工厂的平台落地项目,这里聊聊真实落地过程中的核心问题、选型权衡和踩坑经验,给中级工程师做参考。
为什么你搞的工业数据平台八成用不起来
见过太多项目,老板拍板要做工业大数据,厂商上来就吹大模型、智能预测,钱花了几百万,最后平台只有运维部门偶尔登进去看看,生产、工艺部门碰都不碰。
根子在哪?没人理数据本身。
去年给佛山一家做汽车变速箱壳体的CNC加工工厂做项目对接,他们自己花了两年攒数据,拉出来一看吓一跳:三分之一的传感器数据有空值,不同设备的时间戳差了十几分钟,油温是分钟级采样,刀具电流是秒级,根本拼不到一起。更坑的,老设备RS485输出的十六进制转码错了小半年,人工填写的不合格品记录Excel里,同一个刀具编号有三种写法,还有错别字。
说实话,90%的工业数据项目死在治理这一步。不是挖不出价值,是原始数据根本没法用。
工业数据深度治理的核心:三个绕不开的选型权衡
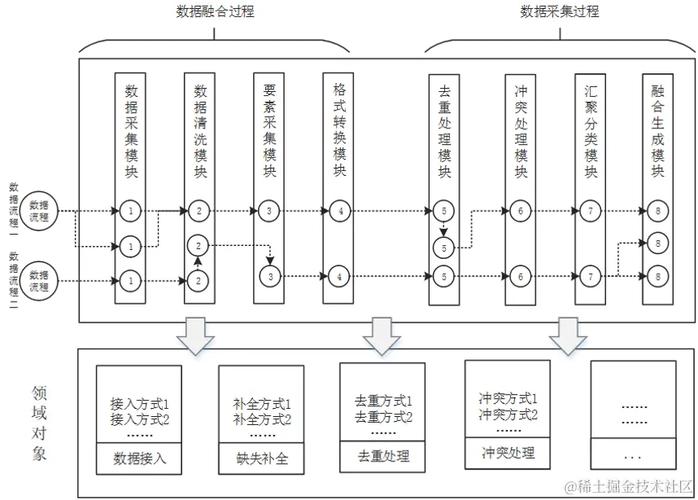
做工业数据深度治理挖掘分析服务平台,第一步不是搭算法框架,是定治理规则,这里三个权衡,我踩过坑,给大家提个醒。
第一个,异常数据怎么处理?很多人上来就要全量清洗,把所有”异常值”全删掉。错了。冲压车间的压力峰值异常,刚好是模具开裂的前兆;CNC主轴电流突升,本来就是刀具磨损的信号,你删了还挖什么?我们现在做平台用的是分层异常标记法,把异常分成三类:传输丢包导致的无效脏数据、设备自身故障导致的干扰数据、工艺/设备劣化产生的有效异常数据,分开存储标记,绝对不直接删除。
第二个,时间同步怎么搞?工业数据最头疼的就是多源不同步。按照GB/T 33704-2017《工业大数据 术语》的规范,我们一般分场景选:做预测性维护,就用事件触发对齐,换刀、启停这些关键事件发生时,锁死所有设备的当前数据,比插值准太多;做全厂能耗统计,用线性插值拉成1分钟等间隔就够,不用搞太复杂。我见过为了毫秒级对齐砸了几十万的,最后发现对结果提升不到1%,纯浪费钱。
第三个,标签体系怎么建?很多平台做十几级标签,光定义文档就上百页,一线工艺员根本记不住。我们现在做的平台,标签只分两级:一级自动打,设备编号、时间、工段这种固定信息,系统自动生成;二级开放给工艺员自己打,比如”这批料硬度超标””今天刀崩了”,人工标注的标签才是挖掘的黄金数据。
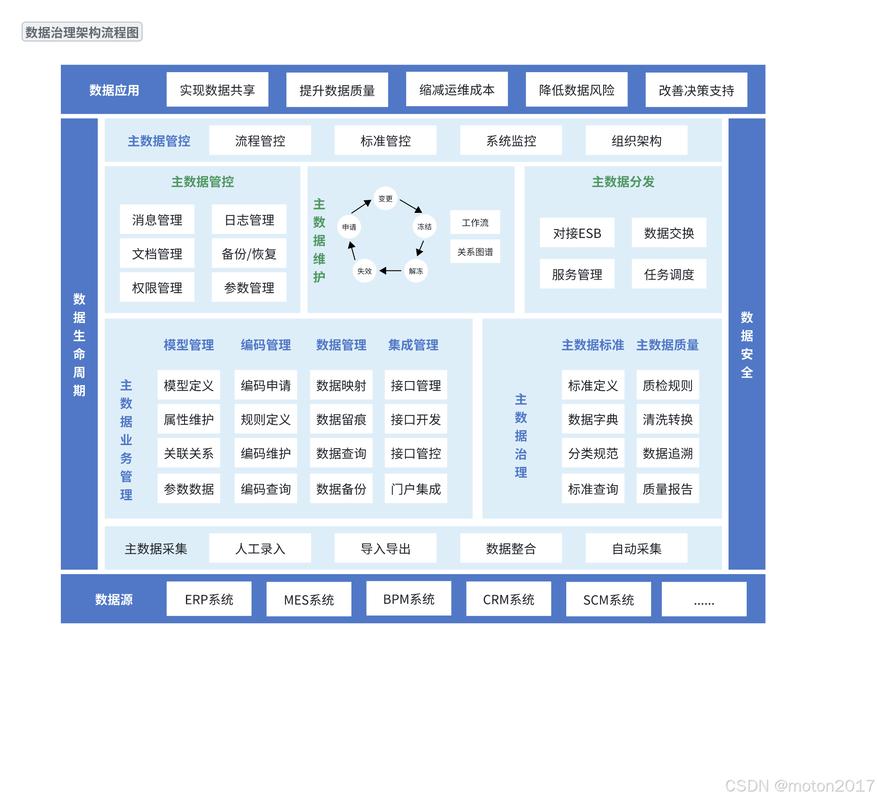
不过话说回来,很多大厂做平台,就喜欢堆复杂功能显得高大上,完全不管一线人用不用,最后烂在服务器里,可惜了钱。对吧?
挖掘分析落地:从治理到产出价值的真实案例
还是说佛山那个变速箱壳体工厂,治理完数据是什么效果?原来他们换刀具都是按固定200工时换,换早了浪费,换晚了出废品,一年光刀具浪费加废品损失就小两百万。
我们治理完数据,数据完整性做到96.2%,符合GB/T 36344-2018《信息技术 数据质量评价指标》的要求,然后把主轴电流、切削温度、工件尺寸公差这些数据按换刀事件对齐,挂上工艺员之前标注的崩刀、换刀标签,跑了一个轻量的XGBoost预测模型,最后结果:能提前8小时预测刀具磨损,误差不超过10分钟。
就这一项,一年给他们省了120多万。废品率降了1.2个百分点。这就是真价值。
说个踩坑的细节,一开始我们做平台,把模型结果做成只读的,工艺员改不了。后来有个干了20年的老工艺员提意见:我明明知道这批原材料硬度比平常高,模型怎么还说刀具能再用10小时?改都改不了,要你这平台有什么用?
我们赶紧加了人工干预修正入口,允许工艺员根据现场经验调整模型输出和参数,结果你猜怎么着?模型整体准确率反而提了5个百分点。
工业现场的变量太多了,今天原材料变了,明天电网电压波动了,哪有什么百分之百完美的自动模型?能让一线人插手调整,才活得下去。
做工业数据深度治理挖掘分析服务平台,核心从来不是堆多少前沿技术,是沉下去把脏数据理干净,贴合现场的真实需求做功能,别搞花架子。能帮工厂省钱、能帮工艺员省时间,就是好平台。
