2026-10-10 14:46:55 分类:材料工艺
去年在新能源车企的复材零部件产线蹲点,碰到个死结。热压出来的顶盖加强件,孔隙率波动卡着良率上不去。换一批预浸料,参数就得重新调,调一次废三五件,一周半个月就过去了。谁都熬不起。
卡了半年的良率死结
热压成型的参数说多不多,升温曲线三段,压力分两段,保温时间,总共也才六七个可控变量。我们照着传统DOE的方法做了二十四组试验,把能想到的交互作用都算了,刚出结果的时候良率摸到85%,大家都松了口气。结果下一批预浸料进场,含水率比上批高了0.23%,良率直接掉去61%。那两个月,实验室的孔隙率切割机天天转,样片堆了半架子,人人脸上都是黑的。谁都搞不明白,为啥参数差个十几秒,结果差出去一大截。
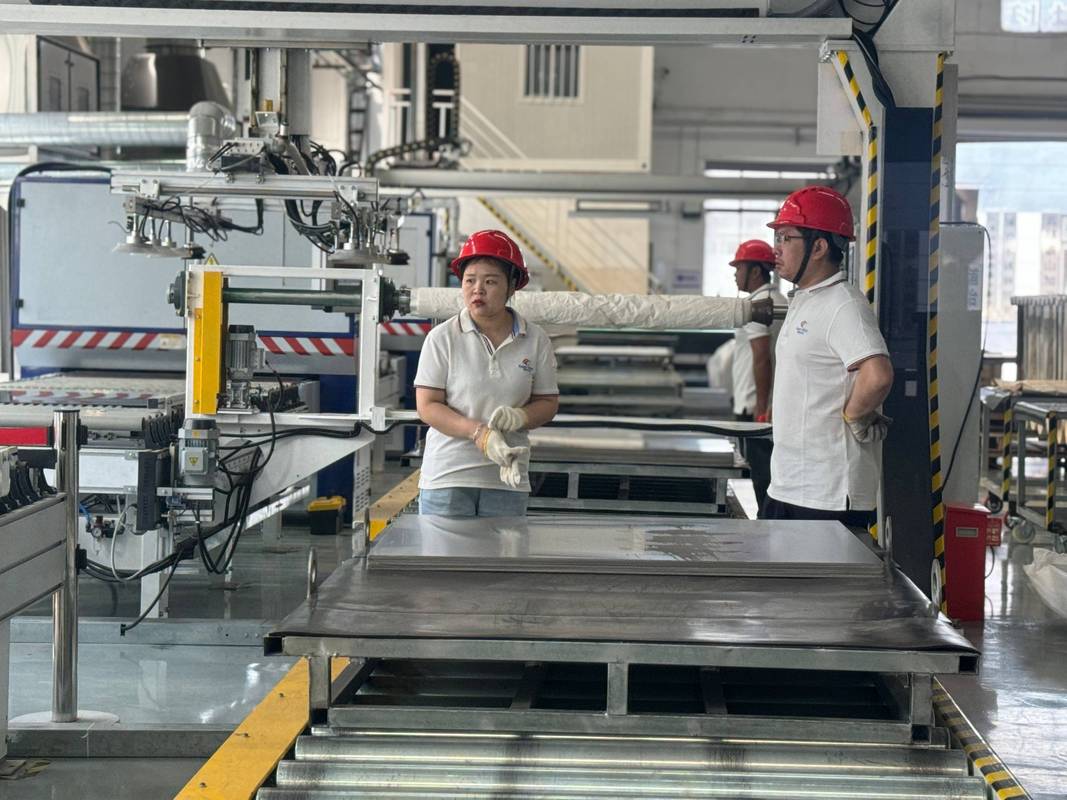 复合材料热压成型产线操作台实拍
小数据集也能出结果
说实话一开始我对这事也犯嘀咕,不就是炒概念吗?我们这点几百条的破数据,也能用得上机器学习?后来抱着死马当活马医的心态,把过去大半年所有的生产记录,每一批的预浸料树脂含量、进厂含水率、生产车间温湿度、每一段工艺的实际采集参数(不是设定值,这点很重要,传感器的实际读数才有用)、最后成品的检测结果,全部整理出来,一共三百一十七组,删了传感器故障的异常值,剩三百零二组。
我们没搞那些花里胡哨的大模型,就用了个梯度提升树,把孔隙率当预测目标,让模型自己算每个参数的影响权重。
 机器学习工艺参数影响权重排序图
结果出来的时候我们都愣了。原来我们盯了大半年的保温温度,影响权重排第五,真正排在第一的,是加压时机和预浸料含水率的匹配关系。我们原来定的规则是凝胶点后60秒加压,模型给的结论是,提前到凝胶点后20秒,而且含水率每升0.1%,加压时间再提前8秒。
这个区间我们原来根本没试过。不敢试啊,试早了树脂流太多,零件缺胶,废一件小一千块。那为啥模型敢给?因为它把所有历史数据里那些我们当初试错瞎调出来的零散数据,都拼起来了,那些我们当初觉得做废了没用的数据,其实都是有效样本。
照着模型给的参数做了第一块样件,切出来测孔隙率,0.8%,远低于要求的2%,强度也达标。当时整个现场都静了两秒,然后有人吹了个口哨。
踩过的坑,和没跨过的边界
 踩过的坑,和没跨过的边界
当然不是一帆风顺。一开始啥变量都往模型里扔,连生产的日期、班组编号都放进去了,结果模型过拟合,实验室算出来准得离谱,一到产线就瞎给参数,废了两块料才反应过来,把无关变量全部砍掉,最后只留了11个跟原材料、工艺直接相关的变量,一下就稳了。
现在跑了快八个月,良率稳定在估算91%左右,比原来的平均72%涨了快二十个点。调新批次参数的时间,从原来的10天缩到2天,不用天天熬夜做试验了。
不过话说回来,现在还是有搞不定的地方。碰到预浸料树脂含量偏差超过2%的极端批次,模型的预测误差直接翻三倍,根本没法用。因为训练数据里本来就没这种情况,你不能怪模型,原材料进厂本来就该卡规格,极端情况本来就得人工调。还有,冬天车间开空调除湿,模型的误差总比夏天闷湿的时候高一点点,我们到现在也没找到是哪个隐变量没加进去,可能是模具表面的温度梯度?还是预浸料存放一周后的水分变化?还在试。
网上说什么一键优化全自动,都是哄人的。真到产线,你得先给模型划好安全边界,超出工艺允许范围的参数,直接砍掉,不能让它瞎出主意。产线停一小时损失几万块,赌不起。
它就是个工具。把你原来散在各个试验本、生产记录里的零碎经验攒起来,把你不敢随便试的参数区间,给你划出个大概的方向。原来你蒙着眼睛摸石头,半个月才能摸到路,现在给你开了个手电筒,路还是得你自己走。对吧。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:复合材料热压成型的机器学习工艺优化:从试错到收敛
文章链接:https://yqhljx.com/list_11/4137.html
