上个月帮长三角一家做汽车变速箱齿轮的厂做数据梳理,现场看到的情况真的头大——ERP系统里存的主轴转速参数,居然是操作工手动敲的,有个班组把1450r/min写成了14500,连续跑了3天的刀具寿命分析报告,全是废数据。
之前碰到过更离谱的,一家做冲压件的厂,数采的压力传感器是接在液压站的回油管上的,测的根本不是冲压油缸的工作压力,是回油的背压——就这数,还被拿去做冲压工艺参数优化,优化了半年,废品率一点没降,后来还是车间的老技师指出来的,数采的管路接错了。
别上来就搭平台:先把“数据血缘”的底摸清楚
很多厂一提到工业数据治理,第一反应就是买服务器、搭大数据平台、招几个算法工程师,恨不得三个月就搞出个数字孪生车间。真的没必要。
就拿那家齿轮厂来说,之前前前后后投了近200万搭数据平台,结果最后平台里跑的数,30%以上是没有来源标记的——老FANUC系统的数采是走OPC UA直连的,新加工中心是通过边缘网关转发的,三坐标的检测数据是每周人工从U盘导进系统的,甚至还有一部分工艺参数是去年技改的时候,供应商直接写进数据库的,连个操作日志都没有。按照GB/T 33863.3-2017里对OPC UA数采的要求,每一个采集点都要明确标记来源、传输路径、校准周期,他们连一半都没做到。
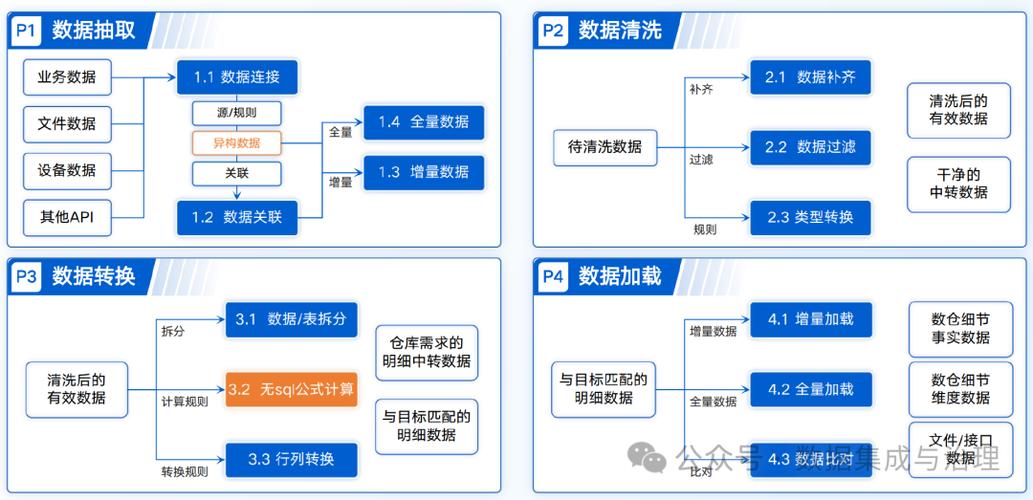
摸数据血缘的时候最容易踩的坑,就是默认“从设备出来的数就是准的”。根本不管中间转了几道手,有没有人改,有没有接错线。刚才说的那个手动录入的主轴转速,就是因为老机床没有对应寄存器的映射点,现场运维图省事,直接在MES界面开了个文本框让操作工填,填了2年,没人核对。
你敢信?这堆数据之前还被拿去算OEE,算出来的设备稼动率比实际值高了22%,厂长还以为是去年技改见效了,差点给车间发了20万奖金。
真的离谱。
清洗不是删错值:要留着“脏数据”的现场语境
很多人对数据清洗的理解,就是把超出阈值的、离群的数全删掉,留着整整齐齐、规规矩矩的数据集,看起来舒服就行。
那家齿轮厂之前就是这么干的:正常加工45钢齿轮的时候,主轴功率在4-8kW区间,他们直接把所有超过12kW的采样点全从数据库里删了,说是“异常值、干扰点”。结果拿清洗完的数据去训练刀具磨损预测模型,实验室测的准确率能到94%,一上线就拉胯——连续漏报了5次刀具崩刃,差点刮伤加工中心的主轴锥孔。
后来翻原始的未清洗数据才发现,那几个被删掉的、超过12kW的功率点,全是当初操作工遇到工件硬点、打刀、进给量卡滞的瞬间。这些点哪里是干扰?这才是刀具故障最核心的特征啊!
按照GB/T 41392-2022《智能制造 机床数据采集规范》里的要求,所有采集到的异常值不能直接物理删除,必须打标签分类标记:是传感器漂移?是真实的工艺异常?还是手动录入的错误?比如传感器漂移的判断标准,就是相邻采样点的跳变值超过传感器量程的10%,且持续时间小于200ms——这种才是可以标记为无效的点,其他的哪怕偏离正常区间,也要留着。
说实话,我之前也犯过这个错。2021年给一家做精密伺服轴的厂做刀具寿命预测,一开始图省事,直接用3σ原则把所有离群点筛掉了,结果模型上线后,连续三次漏报刀具崩刃,损失了快2万的工件和维修费用。那次之后我才明白,数据治理不是把数据变“完美干净”,是把数据变“可解释”。你把那些带着现场真实温度的脏数据全删了,最后得到的就是一堆放在玻璃柜里的展品,看着好看,一点用都没有。
治理完别存冷备份:要给一线工程师留“低门槛调用口”
花了几个月把数据理清楚了,最后全存在冷备份服务器里,只有IT部门的人有查询权限,车间的工艺工程师想找个上个月的切削参数,还要走三级审批,等一周才能拿到结果——这种治理,不如不做。
那家齿轮厂一开始的数仓就是按互联网公司的逻辑搭的,权限卡得特别严,工艺部的张工想对比不同切削参数下的齿轮齿面粗糙度,申请了3次权限都没批下来,最后还是自己拿笔记本记了3个月的生产数据,比数仓里存了3年的数还好用。
后来我们帮他们调整的时候,根本没搞什么复杂的可视化大屏,就是写了个轻量化的Python调用脚本,工艺工程师只要输入对应的零件图号,就能自动拉出来对应批次的切削参数、三坐标检测结果、刀具磨损曲线,不用写SQL,不用找IT申请权限。按照GB/T 39116-2020《智能制造能力成熟度模型》的三级要求,工业数据的核心价值就是支撑一线业务的决策,要是把数据锁在IT的保险柜里,再高质量的数也产生不了价值。
别搞那种高高在上的架构。车间的工程师哪有时间写复杂的查询语句?能让他点两下鼠标拿到要的数,这治理就算成了一半。
现在那个厂的工艺团队,每个月能从数据里挖出来2-3个可落地的参数优化点。比如之前他们通过对比数据发现,把滚齿工序的进给量从0.2mm/r调到0.18mm/r,刀具寿命能提升17%,一年光刀具采购成本就能省40多万。这才是工业数据治理真正要做的事——不是写PPT汇报覆盖率多少,是真的能帮车间省成本、提效率。
前阵子跟那个厂的厂长聊天,他说之前总觉得数据治理是IT部门的事,是给老板看的数字化政绩。现在才明白,这东西本质上就是把车间里大家每天零散记在笔记本上、贴在设备上的经验,攒成一本能查、能用的共享手册。哪有那么多高大上的概念?把每一个数的来源搞清楚,把每一个异常点的来龙去脉记明白,让一线的人真的能用起来,就够了。
