很多工厂做智能制造升级,算力部署要么堆钱买硬件造成浪费,要么算力不够拖垮生产。本文结合实际项目踩坑经验,讲透需求测算、部署架构选型、隐性成本控制三个核心问题,给中级工程师做落地参考。
别上来就堆服务器:先算清楚你的算力需求账
上个月整理旧项目文档,翻出去年东莞汽配车间改造的资料,一脑门子冷汗。当时客户听了厂商宣讲,直接预算拉满订了四台8卡A100服务器,准备上加工仿真、视觉质检、设备预测性维护三套系统。
结果我们进场做需求拆解,一下子就看出问题。错把训练峰值当日常负载,是这个行业最常见的坑。
按照GB/T 39116-2020《智能制造能力成熟度模型》的算力分级要求,不同生产场景的算力需求天差地别:单路2D外观质检单帧推理只需要0.8TOPS,12路同时在线也才不到10TOPS;单工位三维装配仿真的实时路径规划,需要32FP32 TFLOPS;只有预测性维护模型的每周增量训练,才需要128FP16 TFLOPS的峰值算力,而且这个峰值每周只跑4小时,其余时间都是闲置。
原来客户的需求加总下来,日常稳定运行只需要不到100TOPS的推理算力,峰值训练只需要128TFLOPS,厂商给的方案整整多出了三倍的冗余。成本多花了近两百万,利用率还不到20%。
说实话,很多工厂升级都犯这个错,觉得算力多多益善。其实真没必要,适合自己的才对。
边缘还是云端?这里的权衡没几个人说透
不过话说回来,就算需求算对了,部署架构选错了,照样出问题。那个汽配项目一开始,客户还想全上公有云,说省本地硬件钱。
测试的时候出了啥问题?跨网做加工仿真,延迟最高到两秒,机床试切的时候,仿真更新跟不上实际运动,差点撞刀。真的吓出一身冷汗。
实时性要求低于10ms的场景,必须放本地边缘。这条是我踩过坑之后刻在脑子里的铁则。像视觉检测推理、机床实时运动补偿、生产线AGV调度这类场景,一丁点延迟都可能出大问题,绝对不能往公云上放。
那什么放云?非实时的模型训练、批量历史数据分析、全厂级的ERP算力调度,这些对延迟不敏感的,完全可以放云,或者放厂级私有中心节点,按需调度就行。
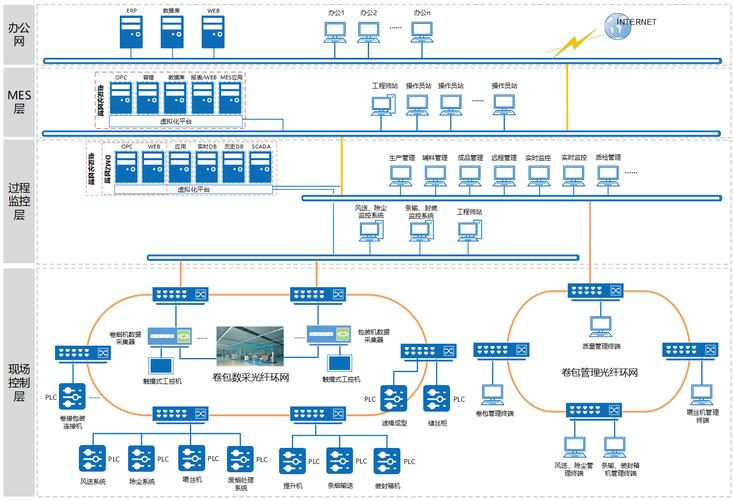
我们后来给客户改了分层方案:每个加工单元旁边放一台盒式边缘算力网关,单节点带24TOPS推理算力,单价不到八千,负责本地的质检推理和仿真实时计算;厂级中心机房放两台GPU服务器,只承接每周一次的模型增量训练和全车间的算力调度。改完之后,总成本降了62%,算力平均利用率提到了72%,高峰时候也没不够用。
容易被忽略的隐性成本:电力和散热坑死人
我见过太多项目,硬件选对了,架构也对,最后栽在电力和散热上。
前年给苏南一个老机床厂做改造,客户自己先买了两台8卡GPU服务器放车间旁边的备用仓库,结果开机半小时,直接跳了全厂的母线零序保护,停了三条生产线,损失十几万。
怎么回事?原来老工厂的配电还是十年前设计的,那个仓库的回路只留了10A的容量,两台8卡服务器,单卡满载350W,一台就2800W,两台快6kW,远远超过回路负载,不跳闸才怪。
还有散热。车间夏天不开空调的话,室温能到40度,很多图便宜用消费级显卡,温度一高直接降频,算力直接砍三成,本来刚好够的算力一下子不够用。
按照ANSI/TIA-942数据中心基础设施标准,厂级算力中心的功率密度要按每机柜8kW预留散热和配电,就算是边缘节点,也要按每平方米1.2kW算容量。老工厂改造一定要提前算配电容量,别等开机跳闸了才后悔。
选型上也有讲究:放在恒温中心机房的,用数据中心级显卡就行,性价比高;放在车间旁边缘柜的,一定要选宽温工业级显卡,-10到60度都能满负荷运行,贵个一两百块钱,换全年稳定,太值了。
做了快十年的工厂自动化改造,我最大的感受是,工厂算力部署从来不是比拼硬件参数,也不是追什么新概念,核心就是贴合自己的生产场景,把每一分钱都花在刀刃上。踩过一两次坑,自然就知道该怎么选了。
