很多人对车间数据治理的认知还停留在买BI工具、搭炫酷数据大屏的阶段,但真正在一线跑过项目的工程师都知道,从采集端的硬件选型,到跨系统的时间对齐,再到给一线留的容错通道,每一个环节的小疏漏,都可能让攒了几个月的数据集变成一堆没人敢用的数字垃圾。上周跟苏州某汽车零部件厂的工艺主管喝冰美式,他说上个月为了算准确的车间OEE,拉了三个工艺员熬了两个通宵,最后算出来的结果比实际产能低17%——就因为采集上来的设备转速数据,近一半是操作工摸鱼的时候手动填的。
采集端的“数据脏病”,90%的车间都中招
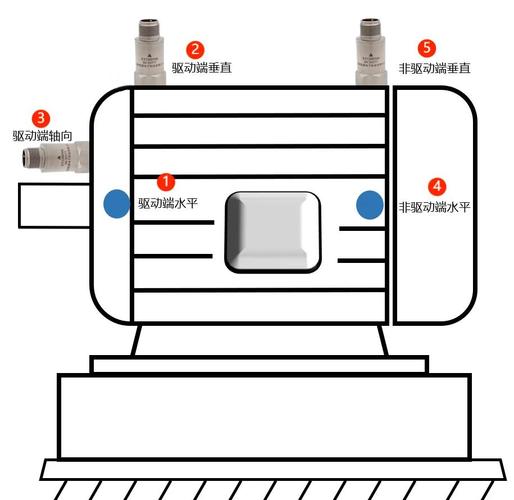
90%的车间数据失真,问题都出在采集端的硬件选型和安装位置上。 之前我们在长三角某重型机械厂做现场调研的时候发现,车间里23台服役超过15年的普通车床,之前为了凑数字化转型的指标,给每台设备装了个贴在床脚的振动传感器,想通过震动频率判断设备的运转状态,结果连旁边5吨行车开过的地面震动都被算法识别成了设备加工信号,算出来的平均开机率高达89%,但我们在车间蹲了整整48小时逐台记录的真实开机率,才刚过42%。
说实话,这种坑我踩过不止一次。之前遇到个冲压车间,PLC里存的是16进制的原始压力码,IT部门的同事没跟工艺员沟通,直接把原始数值导进了数据库,最后做出来的报表里,冲压压力从0到65535无规则跳,工艺员翻了两页报表就把系统关了——根本没法用。
按照GB/T 33918-2017《智能制造 工业数据 分类规范》的要求,设备数据从采集端就要做第一层清洗:比如普通车床的主轴电流低于3A的时候,直接标记为待机状态,不要把空转摸鱼的数算成有效加工时长;冲压机的压力数据要按照传感器的量程做线性换算,别把16进制的原始码直接扔到数据库里。别上来就追求全量采集,之前有个汽车零部件车间上了采集系统,每台设备每10毫秒传一次数据,三个月攒了12T的数,最后想找某批次零件的切削参数,翻了半天日志都定位不到具体的时间点,纯纯浪费存储成本。
别拿“数据对齐”当小事,差2秒的数能让工艺优化全错
跨系统数据的时间戳对齐精度,直接决定了后续工艺优化的可信度。 之前帮某齿轮厂做切削参数和齿面粗糙度的关联优化,一开始把设备PLC存的主轴转速、进给量数据,和粗糙度仪测的表面值拉到一张表里跑回归模型,算出来的拟合优度R值才0.32,两组数据根本没有相关性。整个项目卡了整整三周,后来蹲在测量室跟检测员聊了半小时才找到问题:设备的PLC时钟比实际时间慢了7秒,粗糙度仪测完一个工件,要等10分钟才会把数传到LIMS系统,之前做数据对齐的时候,直接按工件编号硬凑,根本没考虑时序差。
你敢信?就这7秒的时钟差,让整个优化项目白耗了三周时间。
后来我们按照工信部《工业数据分类分级指南(试行)》的要求,把车间所有联网设备统一接入NTP时钟源,把时间同步精度控制在100毫秒以内,给每个工件的全流程操作打统一的批次时间戳——从装夹、切削、测量到入库,每一个环节的参数都和对应的加工时刻绑定。调整完对齐逻辑之后,重新跑的回归模型R值直接升到0.87,最后找出来的最优切削参数,让齿面的粗糙度不合格率从8.2%降到1.3%,光这一项一年就能省20多万的返工成本。当时车间主任看到这个结果,拍着我肩膀说,早知道之前熬的那些夜全是瞎折腾。
数据治理不是一锤子买卖,得给车间留“容错接口”
没有一线员工参与的数据治理,最后一定会变成“自上而下的形式主义”。 很多车间一开始做数据治理,定了特别严苛的校验规则:比如操作工如果填的参数和系统预设的工艺值偏差超过5%,系统直接锁死工位,必须找IT部门解锁才能继续干活。结果呢?之前某新能源电池的装配车间,有次工位的扫码枪坏了,操作工怕系统报警锁工位,干脆把前一个工件的码扫了三遍,最后整批次的追溯数据全错,返工了2000多件,损失了小几十万。
纯纯的形式主义。
真正能落地的治理规则,从来不是把一线操作工当成“需要被监控的对象”,而是给他们留够异常上报的通道。比如数据采集的时候,如果发现某段时间的参数超出工艺阈值,不要直接把数删掉,也不要直接锁工位,弹个简单的弹窗让操作工选个原因:是换刀了?还是来料硬度有问题?还是设备出现小故障?这些带异常标注的数据,恰恰是最有价值的。我们之前做过统计,车间里37%的质量优化方向,全是从这些一线上报的异常标注里挖出来的。
上周那个苏州的工艺主管给我发消息,说他们现在把采集端的手动填数全换成了主轴电流传感器联动,所有设备的时钟统一校了NTP,现在系统算出来的OEE和实际数差不到3%,终于不用每个月熬通宵对数了。
你看,哪有什么高大上的治理模型啊。说白了,就是别坐在办公室对着PPT想当然,多去车间蹲两天,看看操作工怎么干活,看看数据从设备里出来的时候是什么样,比买几百万的BI系统有用多了。
