本文来自三次现场项目改造的实际经验,针对中小离散制造产线多机联动的痛点,讲清楚协同管控平台设计的核心要点,避开常见的工程陷阱,适合准备做同类项目的中级工程师参考。
为什么你做的联动平台总是卡节拍撞机?
去年给长三角一家汽车零部件厂改四条冲压产线,原来甲方自己找团队做了一套多机联动系统,上线三个月撞了三次模具,换型节拍永远卡着达不到设计要求,最后烂尾找我们擦屁股。
拆开程序一看,问题出在哪?说出来你可能不信,就是省了时钟同步的钱。
很多人做协同管控,就是把各个机台的PLC信号用网线连起来,发个动作指令就完事了。完全没考虑,分布式节点之间的时钟偏差。按照GB/T 26707-2011《工业控制系统 实时以太网EPA规范》的要求,多机联动的时钟同步精度必须控制在1μs以内,才能保证高速动作的一致性。
那个项目用普通TCP通信,时钟误差跑到80ms。四台压机加两台上下料机器人,动作差个几十毫秒,那不撞模具才怪。省了几千块的PTP时钟模块钱,最后赔几十万的模具维修费,太亏了。
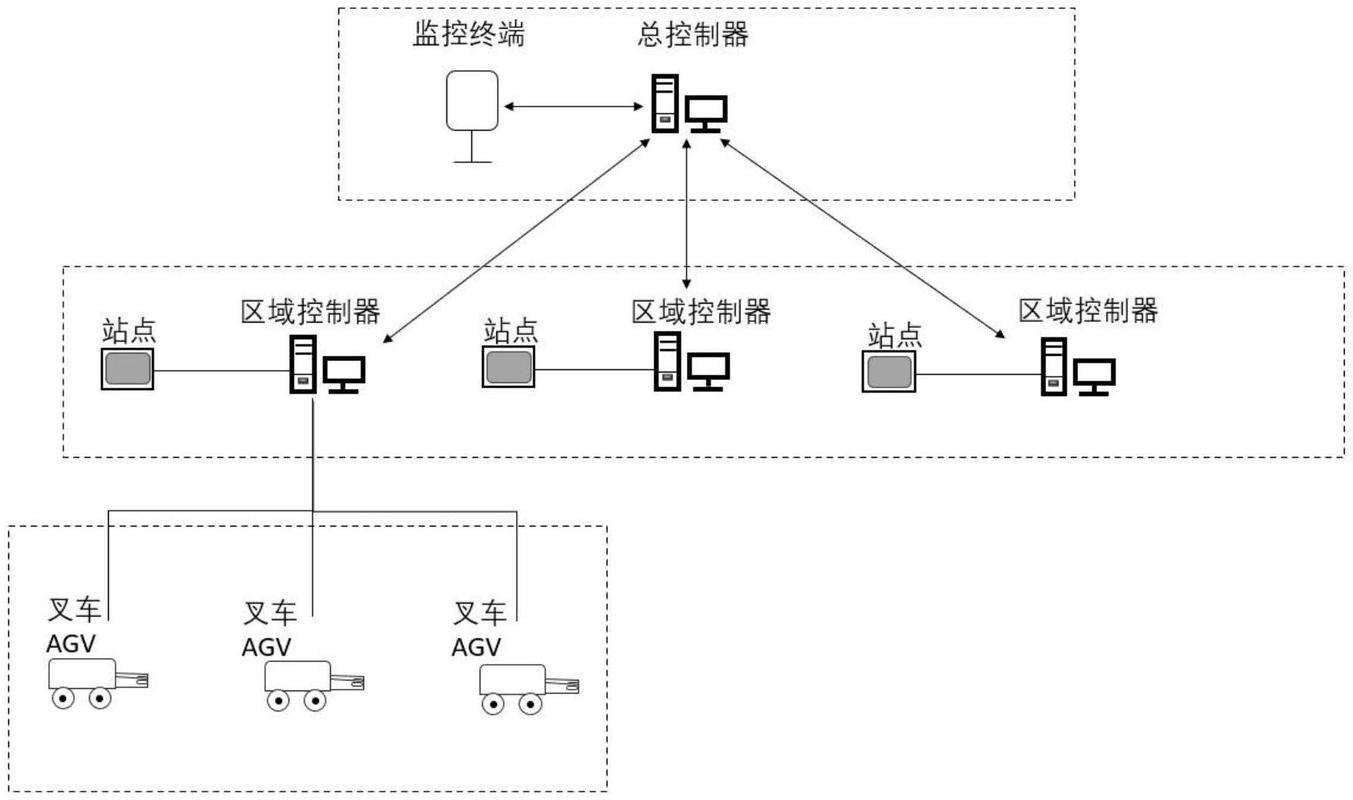
我们改的时候,给每个节点加了支持PTPv2的时钟模块,把时钟误差压到0.2μs以内,上线之后再也没出过动作错位的问题,节拍直接提了12%。
核心逻辑:动态调度怎么选才不浪费算力?
现在很多方案一上来就堆概念,什么数字孪生,什么AI全局优化,一套下来几十万的算力成本,说实话,90%的中小产线根本用不上。
我们做过混线生产的3C组装产线,12台设备联动,做手机和智能手表混流,换料时间随机,原来用的是静态调度表,只要有一台机延迟个十几秒,整个全线都堵死,必须人工重置。
后来我们改了带冲突检测的动态优先级抢占式调度,调度周期设10ms,刚好适配大多数中小型PLC的扫描能力,不会额外占用太多运算资源,同时能满足±50ms以内的节拍误差要求。
不过话说回来,别把优先级设死。很多设计图省事,把下料机的优先级永远设最高,结果遇到换型,上料机堵料了也不让路,最后全线停机。我们加了一个简单的逻辑:每10个调度周期,根据各个机台的实时负载、在制品存量重新算一遍优先级,遇到堵料自动调整,一下子就把停线时间降了70%。
要是你做的是几十台机器的大规模产线,别把所有调度逻辑都塞给主PLC。主PLC扫描周期变长,照样卡节拍,把调度任务扔给边缘计算节点,主PLC只做执行,稳定性高太多。
现场落地容易漏掉的几个细节
第一个是分级急停协同。很多平台做急停,一按就全段断电,高速机器人停在半空中,下次重启回原点要花十几分钟,还废掉一堆在制品。我们的做法是让平台分区域发急停指令:还没进入加工区的工件,直接停在等待位,正在加工的走完当前工序再停,只有检测到碰撞危险的时候才触发全停。就这个小改动,每次急停后的重启时间从15分钟降到2分钟以内。
第二个是权限绑定。产线换班,什么人都能改协同参数?出过事的,学徒工误碰改了优先级,直接撞机。平台一定要做机台级的权限绑定,普通操作工只能看,改调度参数、节拍参数必须要带班工程师授权,没什么技术难度,就是容易忘。
第三个是全局统一日志。协同出了问题,到底是谁先错的?原来每个机台存自己的日志,时间对不上,查个错要查三四天。一定要做统一时戳的全局日志,所有事件都存在边缘节点,精度到微秒,出了问题拉出来排序,十分钟就能定位问题。上次我们处理一个疑难故障,十分钟就查到是机器人编码器反馈延迟了28ms,换个模块就好,放在原来的设计,半个月都查不出来。
做这个平台,核心不是堆多少新技术,是把基础逻辑做扎实,贴合现场的实际需求。很多花里胡哨的功能,上线一年半载都用不到一次,把时钟同步、调度逻辑、异常处理这几个核心点做稳,就能解决80%的多机联动问题。
