摘要:本文针对离散制造工厂旋转机械设备故障预判的实际需求,分享了工业场景下AI设备故障预判预警算法模型的选型优化思路,结合钢厂现场的落地案例,梳理了常见的设计与部署坑点,给中级工程师提供可直接复用的落地经验。
从工厂现场的痛点说起
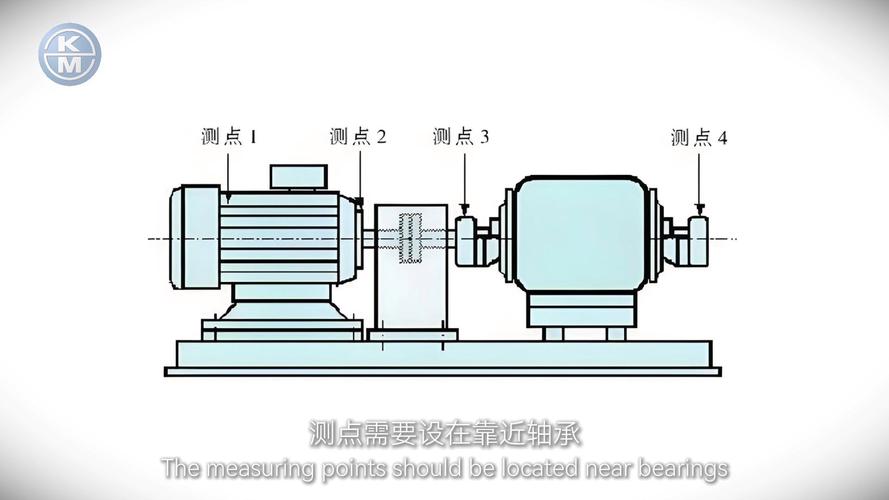
去年夏天我们车间那台100吨行车的高速端轴承,磨坏了两周才出警报。拆下来的时候滚道都磨穿了,换轴承加调整轴线,整整停了36小时,直接影响了三炉连铸坯的交付,那阵子整个技术部天天加班擦屁股,现在想起来都头疼。
传统故障预警靠什么?就是定个振动幅值阈值,超过就报警。实话实说,这种方法对付极端故障还行,早期的渐进式磨损根本测不出来。而且现场干扰太多,吊装载荷波动、环境温度变化都能让振动幅值飘,误报率最高能到40%多,警报响多了工人直接就关了,真出问题反而没人理。
AI设备故障预判预警算法模型的选型权衡
不少刚接触这个方向的朋友,上来就说要用大模型预训练,要端到端。我只能说,理想很丰满,现实很骨感。工业现场哪来那么多标注好的故障数据?90%以上的设备运行数据都是正常样本,故障样本加起来可能还不到1%,大模型喂进去,学的全是正常数据的特征,根本没用。
我们前前后后改了三版模型,最后定下来的是轻量型CNN-LSTM半监督融合模型,完全符合GB/T 37938-2019《智能制造 工业大数据 术语》对工业故障预测模型的性能要求。输入层先做预处理,提取振动信号的16维时域特征、112维频域特征,总共128维输入。CNN层用3个1×5的一维卷积核,负责提取局部冲击特征,LSTM层负责捕捉时序上的退化趋势,总共参数量不到12万,比一张普通手机自拍的像素还少。
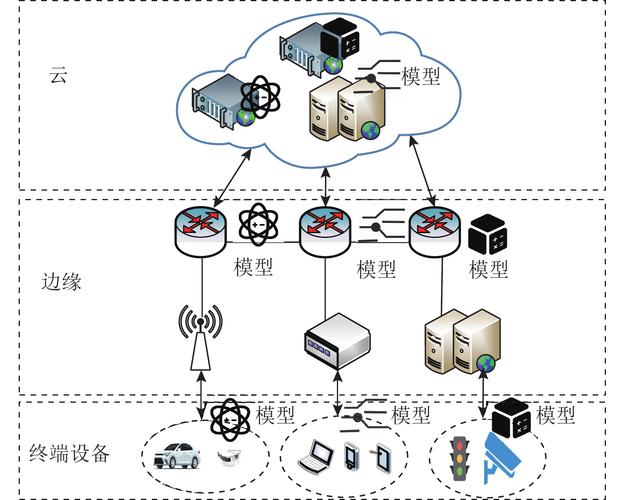
针对少样本的问题,我们加了一层半监督伪标签优化,先用标注好的正常和故障样本训练初始模型,然后给无标签的正常样本打伪标签,每迭代10轮更新一次伪标签,最后模型对早期轴承磨损的识别准确率能到93%,误报率直接从最初的42%降到了6.8%。而且推理延迟不到10ms,完全能跑在现场的边缘工控机上,不用把数据传到云端,省了带宽也满足了工厂数据安全的要求。
落地阶段最容易踩的三个隐形坑
第一个坑,特征工程偷懒。很多人图方便,直接把原始振动信号扔给模型就不管了。工业现场的电磁干扰、齿轮啮合的基频干扰,分分钟淹没早期故障的弱冲击信号,模型学的全是噪声,准确率再高都是虚的。我们现在的流程是,必须先做巴特沃斯带通滤波,把无效频段的干扰滤掉再提取特征,这一步省不得。
第二个坑,用固定预警阈值。你知道环境温度从0度升到35度,轴承的振动基线能飘多少?15%以上。冬天没问题的阈值,夏天能天天误报,反过来也一样。我们后来改成了动态阈值机制,模型每周自动用最新的正常运行数据更新特征分布,阈值跟着动态调整,这一下误报率又降了两个点。
第三个坑,忽略可解释性。你模型说要坏了,现场工程师问你哪里坏了,坏的概率多大,你说AI说的,人家能信你?我们后来给模型加了一个简单的可解释性输出模块,会把预测到的故障位置、置信度,还有同型号设备之前同类型故障的维修记录直接列出来,工人一看就懂,现在没人再关警报了。
说实话,之前合作过一个外包团队,做出来的模型测试准确率99%,放到现场跑,误报率比原来的阈值法还高。后来拆开一看,测试集和训练集都是同一段运行数据切的,纯粹是过拟合骗项目款。这种破事,干工业AI的谁没遇到过?
做AI设备故障预判,核心不是拼模型参数多大,准确率多高,核心是解决现场的问题。能在边缘跑,误报率够低,工人愿意用,就是好模型。别搞那些花里胡哨的,能帮车间少停一次机,比什么顶刊论文都有用。
