摘要:很多制造工厂在数字化升级过程中,各个部门分别采购算力,导致闲的闲死、忙的忙死,算力成本居高不下。工厂算力资源统一调度是解决这个问题的核心方案,但超过六成的项目落地后变成摆设。本文结合三次实际工程改造经验,讲清落地中的核心坑点、选型权衡,给中级工程师提供可落地的实操参考。
前几年帮东莞一家做新能源汽车结构件的工厂做数字化改造,进门就听见信息部主管在骂人。原来工艺部要做电池包跌落仿真,排了三天队还没轮到,对面研发部的三台服务器,闲了快两个月,连风扇都不怎么转。这不离谱吗?
这种情况在国内制造工厂太常见了。数字化转型喊了这么多年,每个部门上项目都自己买算力,攒下来一堆零散的资源,没人统筹。算下来整个工厂的平均算力利用率不到20%,每年花大价钱扩算力,其实大部分都浪费了。
为什么很多工厂搞统一调度最后成了摆设?
我见过最多的错误就是上来就砸钱买一套全新的大一统调度平台,不管原来的算力是什么架构,什么年限,都硬要往里塞。有的工厂里还有2015年买的老工控机,系统都是Windows XP,厂商都找不到了,硬要做接入,光适配就花了一年多,上线的时候业务需求都变了,钱砸进去水漂都没一个。
去年帮长三角一家注塑机整机厂做改造复盘,他们前年花了两百万上调度平台,上线半年没人用。为什么?平台要求所有任务都必须上传到平台统一调度,工程师原来习惯把小仿真放自己电脑跑,传上去还要填一堆参数,嫌麻烦,干脆还是自己用自己的,最后平台就成了信息部的一个监控大屏,摆着看。
还有一个常见错误,就是把互联网公司的那套直接搬过来。互联网的算力都是同架构的云服务器,拿来就能用,工厂的算力是什么?有私有云的大服务器,有车间边缘的工控机,有检测设备的空闲计算单元,甚至还有工程师笔记本的闲置资源,复杂度完全不在一个量级。硬套阿里腾讯的调度架构,最后就是水土不服。
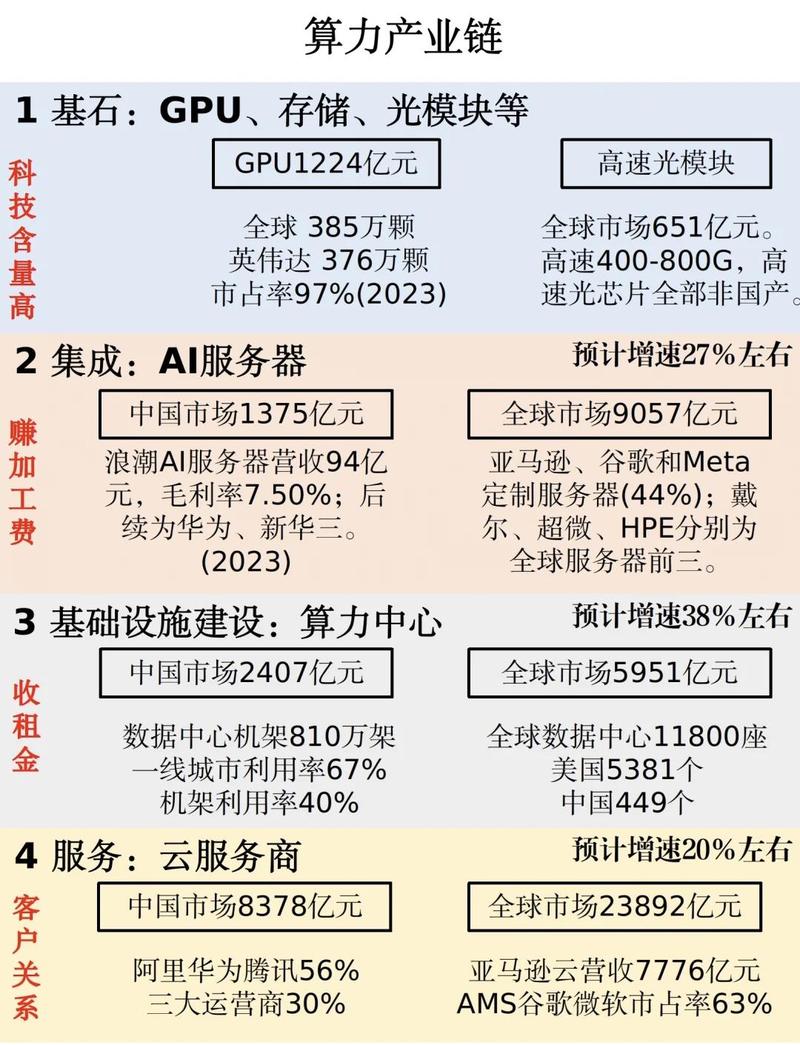
落地工厂算力资源统一调度的核心权衡
说实话,做工厂算力调度,核心不是选最先进的技术,是选最适配自己业务的。我现在做项目,第一步永远是给工厂的算力做分级,绝不分乱七八糟的类别。
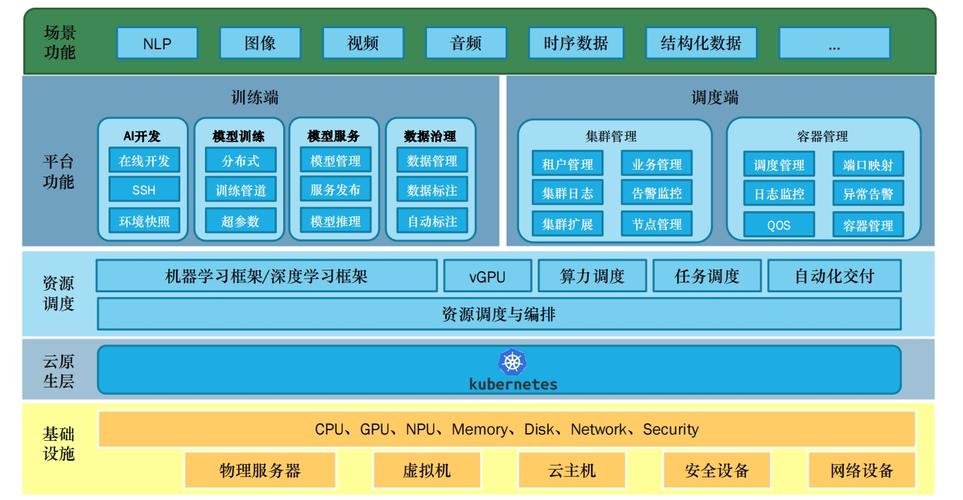
我一般把工厂算力分成三类:核心固定算力就是厂区私有云中心的专用服务器,常年稳定在线,用来跑有限元仿真、数字孪生全局模拟这类大计算量长周期任务,按照GB/T 39116-2020《智能制造系统 算力服务要求》的规范,这类算力的可用性要达到99.9%以上。边缘闲置算力就是各个工位的工控机、在线检测设备的空闲算力,只有在设备待机、下班之后才会释放出来,用来跑批量参数优化、小模型推理这类对延迟要求不高的任务。弹性公共算力就是按需租赁的公有云算力,只在订单峰值,核心算力占满的时候才调用,按使用量付费,省成本。
调度规则也不用搞太复杂。很多团队上来就要用深度强化学习做动态调度,我就一句话,没必要。对于90%的年产值十亿以下的制造工厂,改进型的最大最小公平调度算法就够用了,核心逻辑就是高优先级任务优先占资源,低优先级任务闲时跑,还支持断点续跑,代码开源就能用,现场维护难度低,出问题随便一个工程师就能调。
任务优先级怎么定?记住一个原则:和实时生产绑定的任务优先级最高,必须放本地边缘算力,延迟不能超过100ms,绝对不能跨车间调度。研发类仿真任务优先级次之,可以排队等资源。对,就是这么简单。
现场实施必须记牢的踩坑经验
我自己踩过,也见过别人踩过太多坑,挑三个最痛的给大家说。
第一个坑:算力监控只看CPU利用率。这是最低级也最常见的错误。现在大部分工厂的研发任务都是仿真、AI推理,全靠GPU干活,很多时候CPU利用率才20%,显存早就跑满了,平台还往上面塞新任务,结果直接显存溢出崩溃。我早年刚做这个的时候吃过一次亏,一次汽车覆盖件冲压成型仿真,跑了24小时快出结果了,直接崩了,项目延期一周,扣了半个月工资,心疼到现在。现在我们做监控,必须做四维监控:CPU利用率、GPU显存占用、磁盘IO、网络带宽,四个维度加权计算负载,仿真任务显存权重给到70%,数据传输任务带宽权重给到60%,完全根据业务调,没有通用值。
第二个坑:不考虑工厂网络的实际波动。很多做调度的工程师都是搞IT出身,默认工厂网络和办公室一样稳定,其实工厂车间的无线信号干扰大,跨车间的有线网络也经常有设备抢占带宽,延迟波动能差好几倍。之前听说隔壁厂把设备故障预测的推理任务调度到两公里外的云计算中心,本来要求延迟不超过50ms,结果高峰时候延迟跑到300ms,推理结果出来晚了,切刀错了,一整批工件切废,几十万直接打了水漂。现在我们做调度,一个原则就是:本地任务本地做,非必要不跨网段,核心控制链路走有线千兆,绝对不走公用WiFi。
第三个坑:不给高优先级任务留抢占冗余。很多平台做调度,任务占了资源就一直占着,高优先级任务来了也插不了队,要么排队,要么挤掉低优先级任务还不保存断点,下次还要重新跑,浪费大把算力。现在我们做的规则是,只要核心任务过来,低优先级的非实时任务自动暂停,保存断点,核心任务跑完再自动继续,一点不浪费。
工厂算力资源统一调度不是用来凑智能制造KPI的面子工程,是真金白银省钱的。原来东莞那家工厂改完之后,整体算力利用率从原来的16%提到了63%,原来每年计划花两百万新增服务器,现在四年过去了都没加过,省下来的钱够给整个研发部发两年年终奖。
不过话说回来,千万别贪大求全。一开始不用把所有算力都接进来,先把研发部仿真业务的调度跑通,跑顺了再慢慢扩到生产端的数字孪生、AI推理,稳扎稳打,比什么都强。
